Что такое алгоритмы
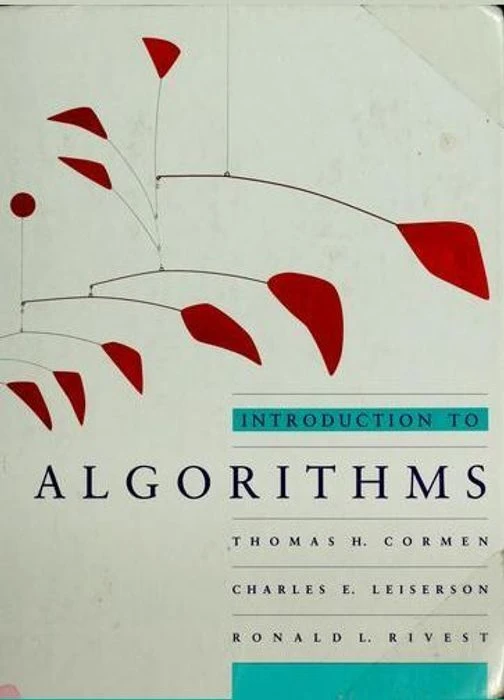
Introduction to Algorithms
Самая известная в мире «библия» по алгоритмам для программистов.
Программа вечера
 Антон Помазков
 Артём Никифоров
Кто написал эту книгу
 C
Дартмутский колледж, почётный профессор информатики
Карьера
- Защитил докторскую в MIT, с 1992 года преподаёт в Дартмуте
- Много лет возглавлял факультет информатики, а до этого — институт письма и риторики: редкая пара должностей
Вклад в алгоритмы
- Алгоритмы внешней памяти и параллельного ввода-вывода: как считать то, что в оперативную память не помещается. страница в Дартмуте ↗
- «Алгоритмы. Вводный курс» — та же программа без математического аппарата. MIT Press ↗
- В самой книге отвечает за то, чтобы строгий материал можно было прочитать: псевдокод, формулировки, разбор рекуррентностей.
 L
MIT, профессор электротехники и информатики
Карьера
- Ведёт в MIT курс алгоритмов, по записям которого учится полмира
- Сооснователь Cilk Arts; технологию выкупила Intel — так появился Cilk Plus
Вклад в алгоритмы
- Придумал fat-tree — топологию сети суперкомпьютера Connection Machine CM-5. IEEE Trans. Computers, 1985 ↗
- Cilk и планировщик с перехватом работы; сегодня развивается в MIT как OpenCilk. cilk.mit.edu ↗
- Из этих работ выросла глава книги о многопоточных алгоритмах. Премия ACM Paris Kanellakis, 2013.
 R
MIT, Institute Professor, криптограф
Карьера
- Institute Professor — высшее звание MIT, его носят единицы
- Сооснователь RSA Security; много лет занимается проверяемыми системами голосования
Вклад в алгоритмы
- Буква R в RSA: шифрование с открытым ключом, 1977 год. оригинальная статья ↗
- «Медиана медиан»: выбор k-го по величине элемента за линейное время — этому посвящена отдельная глава книги. Time Bounds for Selection, 1973 ↗
- Глава о теории чисел и криптографии — его область. Премия Тьюринга, 2002.
 S
Колумбийский университет, профессор исследования операций и информатики
Карьера
- Защитился в MIT, преподавал в Дартмуте вместе с Корменом, с 2001 года — в Колумбийском университете
- Заведовал кафедрой исследования операций, руководил институтом науки о данных
Вклад в алгоритмы
- Приближённые алгоритмы для NP-трудных задач и теория расписаний — его исследовательская тема. профиль в Колумбийском университете ↗
- Потоки в сетях и комбинаторная оптимизация: отсюда главы о потоках и о приближённых алгоритмах.
- Присоединился ко второму изданию — до 2001 года книгу звали CLR. страница книги, MIT Press ↗
Почему именно эта книга?
Четыре издания за тридцать два года
-
 1990первое издание
-
Штайн в соавторах — книга становится CLRS. Новые главы: «Роль алгоритмов» (та самая, что разбираем), вероятностный анализ, линейное программирование.
-
 2001второе издание
-
Деревья ван Эмде Боаса и многопоточные алгоритмы. Глава о рекуррентностях становится «Разделяй и властвуй», добавляется приложение о матрицах.
-
 2009третье издание читаем это
-
Паросочетания в двудольных графах, онлайн-алгоритмы, машинное обучение. Плюс суффиксные массивы, 140 новых упражнений и цвет в вёрстке.
-
 2022четвёртое издание
Текущее. Сайт с дополнительными материалами.
Чем отличается от других книг по алгоритмам
Доказывает, а не заявляет
Корректность выводится из инварианта цикла, время работы — из рекуррентности. Не «поверьте, тут O(n log n)».
Псевдокод вместо языка
Идея не тонет в синтаксисе и не устаревает вместе с фреймворком. Перенести на JS или Rust — работа на десять минут.
Весь путь задачи целиком
Постановка → идея → псевдокод → доказательство → анализ времени. Большинство книг обрывают путь сразу после кода.
Широта справочника
Сортировки, структуры данных, графы, потоки, NP-полнота, криптография, БПФ, геометрия — одна книга вместо десяти.
Главы самодостаточны
Читается и подряд, и точечно: пришли за хеш-таблицами — взяли главу 11 и ушли. Поэтому книга живёт на столе, а не на полке.
Что такое алгоритм
Алгоритм — любая корректно определённаяКлючевое слово — корректно определённая: каждый шаг должен быть описан так точно, чтобы его нельзя было понять двояко. вычислительная процедура, на вход которой подаётся некоторая величина или набор величин, а результатом выполнения является выходная величина или набор значений.
Величина или набор величин, которые мы подаём процедуре.
Последовательность вычислительных шагов, преобразующих вход в выход.
Результат — то, ради чего процедура запускалась.
Это вы пишете каждый день
Любая функция, которая что-то получает и что-то возвращает, — это вход, алгоритм и выход. Отличие учебного алгоритма только в том, что про него мы умеем доказывать корректность и считать время работы.
const users = [
  { name: 'Аня', rating: 41 },
  { name: 'Борис', rating: 31 },
  { name: 'Вера', rating: 59 },
];

const byRating = (a, b) => a.rating - b.rating;

const sorted = [...users].sort(byRating);
Наведите курсор на любой блок кода слева — здесь появится его роль из определения алгоритма.
Величина или набор величин, которые мы подаём процедуре.
здесь — массив users в произвольном порядке
Последовательность вычислительных шагов, преобразующих вход в выход.
здесь — правило сравнения и процедура упорядочивания внутри sort
Результат — то, ради чего процедура запускалась.
здесь — перестановка users, неубывающая по rating
Метод sort — это чей-то алгоритм, реализованный в движке.
Кто-то доказал, что он корректен, и посчитал, сколько времени он потратит.
Вопрос лишь в том, хотите ли вы быть тем, кто умеет это делать.
Алгоритм — инструмент
Алгоритм можно рассматривать как инструмент для решения корректно поставленной вычислительной задачи computational problem.
Какие отношения должны связывать вход и выход.
Задача — это контракт Задаёт только отношение входа и выхода: «последовательность чисел → та же последовательность по неубыванию». Про способ — ни слова. Формулируется один раз, решений допускает сколько угодно. Практическая польза: пока задача не записана точно, спорить об алгоритмах бессмысленно — непонятно, что считать правильным ответом. Отсюда же берутся тесты: они проверяют контракт, а не реализацию.Процедура, которая эти отношения обеспечивает.
Алгоритм — это реализация контракта Сортировка вставками, слиянием, быстрая — три разных алгоритма одной задачи. Ответ у них одинаковый, отличается цена: время и память. Практическая польза: если реализацию можно заменить, не меняя ожиданий, — задача и алгоритм разделены, и вы вправе выбирать по цене. Если нельзя — контракт протёк в код, и любая замена станет переписыванием.Алгоритм на конкретном языке и конкретном железе.
Программа — это алгоритм, встретившийся с реальностью Здесь появляется всё, чего в алгоритме не было: типы, кеш процессора, предсказание ветвлений, сборщик мусора. Практическая польза: асимптотику меряют у алгоритма, а секунды — у программы, и одно не заменяет другое. Поэтому «переписали на Rust» ускоряет в разы, а «сменили алгоритм» — на порядки.Одну задачу решают много разных алгоритмов, а один алгоритм можно записать на десятке языков. Поэтому изучают именно алгоритмы — они переживают и языки, и фреймворки.
Пример: задача сортировки
Сортировка часто возникает на практике и служит благодатной почвой для знакомства со многими стандартными методами разработки и анализа алгоритмов — поэтому книга начинает именно с неё.
такая, что a₁′ ≤ a₂′ ≤ … ≤ an′
Что должно получиться
Если на вход подаётся ⟨31, 41, 59, 26, 41, 58⟩, вывод алгоритма сортировки должен быть ⟨26, 31, 41, 41, 58, 59⟩ — и никакой другой.
Вход
Выход — неубывающая перестановка
Экземпляр задачи
Экземпляр instance — конкретные входные данные, удовлетворяющие всем ограничениям постановки задачи, необходимые для её решения. Задача одна, экземпляров — бесконечно много.
Вход — экземпляр задачи
Выход — неубывающая перестановка
Корректный алгоритм обязан справляться со всеми экземплярами задачи, а не с тем, что вы подставили в тесте.
Что значит «корректный алгоритм»
Алгоритм корректен correct, если для любых входных данных результатом его работы являются корректные выходные данные. Говорят, что корректный алгоритм решает данную вычислительную задачу.
Не «мои три теста», а каждый допустимый вход задачи.
Работа заканчивается за конечное число шагов — иначе ответа нет вовсе.
Выход удовлетворяет отношениям, записанным в постановке задачи.
Корректность — это свойство алгоритма, а не отчёт о прогоне тестов. Её доказывают, а не наблюдают.
Некорректный алгоритм
Если алгоритм некорректен, то для некоторых входов он может вообще не завершить работу или выдать неправильный ответ. Но есть и третий исход — когда ошибка допустима.
Не завершается
Программа виснет на определённых данных. Ответа нет вообще — и хуже всего, что вы не знаете, ждать ещё или уже нет.
Отвечает неправильно
Ответ есть, выглядит правдоподобно — и он неверный. Такое обнаруживается позже всего и стоит дороже всего.
Ошибается, но контролируемо ?
Когда это норма: частоту ошибок можно посчитать и сделать сколь угодно малой. Наведите — пример из главы 31.
Тем не менее обычно нас интересуют только корректные алгоритмы — «иногда ошибается» должно быть осознанным решением, а не свойством, которое вы обнаружили в проде.
Где может существовать алгоритм
Алгоритм может быть задан на естественном языке, в виде компьютерной программы или даже воплощён в аппаратном обеспечении. Ниже — один и тот же шаг сортировки вставками в трёх видах.
Естественный язык
Рецепт, инструкция, псевдокод в книге. Ровно так алгоритмы описывали за тысячи лет до компьютеров.
INSERTION-SORT(A)
  for j = 2 to A.length
    key = A[j]
    i = j - 1
    while i > 0 and A[i] > key
      A[i + 1] = A[i]
      i = i - 1
    A[i + 1] = key
Компьютерная программа
Код на JavaScript, Rust, C — привычная для нас форма. Язык не меняет сути алгоритма.
function insertionSort(a) {
  for (let j = 1; j < a.length; j++) {
    const key = a[j];
    let i = j - 1;
    while (i >= 0 && a[i] > key) {
      a[i + 1] = a[i];
      i--;
    }
    a[i + 1] = key;
  }
}
Аппаратная реализация
Схема в кремнии. В главе 30 книга приводит не только алгоритм БПФ, но и набросок проекта микросхемы для него.
Спецификация должна предоставлять точное описание вычислительной процедуры, которую требуется выполнить. Форма записи вторична — точность обязательна.
Где применяются алгоритмы
Вычислительные задачи, для которых разработаны алгоритмы, отнюдь не ограничиваются сортировкой. Дальше — четыре примера из книги, намеренно из очень разных областей. Карточки кликабельны: каждая ведёт на свой разбор.
Общее у всех четырёх: без алгоритмов задача либо не решается вообще, либо решается так долго и дорого, что это уже не решение.
Проект по расшифровке генома человека
Цель проекта — идентифицировать все гены ДНК человека, определить последовательности трёх миллиардов базовых пар, отсортировать эту информацию в базах данных и разработать инструменты для её анализа. Для всех этапов нужны сложные алгоритмы — и вот какие именно.
Граф де Брёйна
Секвенатор выдаёт миллиарды коротких прочтений. Их режут на слова длины k: слово — вершина графа, перекрытие — ребро, а сборка генома превращается в поиск пути через этот граф. Так работают Velvet и SPAdes.
родня из книги: графы, главы 22–24 Zerbino & Birney, Genome Research, 2008 ↗Смит — Уотерман
Выравнивание двух последовательностей: заполняем таблицу, где каждая клетка считается по трём соседям. Это буквально та же схема, что у длиннейшей общей подпоследовательности, — динамическое программирование.
родня из книги: ДП, глава 15 Smith & Waterman, J. Mol. Biol., 1981 ↗BLAST
Честный Смит — Уотерман против всей базы последовательностей не успеет никогда. BLAST строит хеш-индекс коротких слов, находит точные затравки и расширяет только их — приближённо, зато за секунды. Главный инструмент биоинформатики уже тридцать пять лет.
родня из книги: хеш-таблицы, глава 11 Altschul et al., J. Mol. Biol., 1990 ↗Барроуз — Уилер, FM-индекс
Чтобы разложить прочтения по референсному геному, Bowtie сжимает индекс всего генома человека до ≈1,3 ГБ — он помещается в память ноутбука — и выравнивает больше 25 миллионов прочтений на процессор-час.
родня из книги: поиск подстрок, глава 32 Langmead et al., Genome Biology, 2009 ↗Машинное время — расчёт, который шёл бы годами, укладывается в часы · время сотрудников — учёные заняты наукой, а не ожиданием · деньги — меньше вычислений, меньше счёт за инфраструктуру · лабораторное оборудование — дорогие приборы простаивают реже.
Интернет: две задачи
Интернет позволяет пользователям в любой точке мира быстро получать доступ к информации и извлекать её в больших объёмах. Работать с такими объёмами сайтам помогают хитроумные алгоритмы.
Как доставить данные
Узлы сети — вершины графа, каналы связи — рёбра. Маршрутизатор должен находить кратчайший путь для каждого пакета, в сети, которая постоянно меняется.
Методы решения — глава 24 Глава 24 · «Кратчайшие пути из одной вершины» Дейкстра растит множество вершин с уже известным расстоянием, каждый раз забирая ближайшую из очереди с приоритетами, — работает, пока веса рёбер неотрицательны. Беллман — Форд медленнее, зато переживает отрицательные веса и умеет сообщить, что кратчайшего пути нет вовсе из-за отрицательного цикла. Интернет-маршрутизация построена ровно на этой паре: OSPF внутри автономной системы считает Дейкстрой, а дистанционно-векторные протоколы вроде RIP — это распределённый Беллман — Форд.
волна обхода расходится от отправителя, затем подсвечивается найденный кратчайший путь
Как найти нужное
Поисковик не просматривает страницы заново. Он заранее строит обратный индекс: слово → список документов, где оно встречается.
Хеш-таблицы глава 11
Глава 11 · «Хеш-таблицы»
Индекс и есть большая хеш-таблица: по слову запроса список документов достаётся в среднем за O(1),
независимо от того, миллион в индексе слов или миллиард. Дальше остаётся пересечь несколько таких списков —
вместо того чтобы просматривать сами страницы. В книге здесь же разбирается, почему хеш-функция должна
«размазывать» ключи равномерно и что делать с коллизиями.
и поиск подстрок глава 32
Глава 32 · «Поиск подстрок»
Индекс отвечает, в каком документе есть слово, но не где именно в тексте стоит фраза.
Для этого — Кнут — Моррис — Пратт: он заранее считает по образцу таблицу префиксов и потому никогда
не откатывается назад по тексту, отрабатывая за O(n + m). И Рабин — Карп: он сравнивает
не символы, а скользящий хеш окна — тем же приёмом ищут плагиат и дубликаты страниц.
сверху курсор идёт по всем документам, снизу индекс сразу называет нужные
Электронная коммерция
Электронная коммерция позволяет заключать сделки и предоставлять товары и услуги электронными средствами. Её распространённость существенно зависит от способности защищать информацию: номера кредитных карт, пароли, банковские счета.
Криптография с открытым ключом
Ключей два: открытым зашифровать может каждый, расшифровать — только владелец закрытого. Поэтому магазину не нужно заранее договариваться с вами о секрете.
глава 31 Глава 31 · «Теоретико-числовые алгоритмы» Там разбирается RSA — та самая схема Ривеста, Шамира и Адлемана. Стойкость держится на том, что перемножить два больших простых числа легко, а разложить произведение обратно — нет. Рабочие инструменты главы: алгоритм Евклида для НОД, быстрое возведение в степень по модулю и вероятностный тест простоты Миллера — Рабина, которым генерируют сами простые числа для ключей.Цифровые подписи
Та же математика наоборот: подписывают закрытым ключом, проверяют открытым. Подтверждают, что сообщение отправил именно тот, кто заявлен, и по дороге его не подменили.
глава 31 Глава 31 · цифровая подпись RSA Подпись — это хеш сообщения, зашифрованный закрытым ключом. Проверяющий расшифровывает её открытым ключом и сравнивает с хешем, который посчитал сам: совпало — значит, подписал владелец ключа и текст не менялся. На этом стоят сертификаты TLS, из-за которых браузер показывает замок, и подписи пакетов в npm и дистрибутивах.Производство и коммерция
Один класс задач с одной формулой: ограниченные ресурсы → максимальная выгода. Меняются только декорации.
Нефтяная компания
Где пробурить скважины, чтобы получить как можно более высокую прибыль?
ресурс — места буренияКандидат в президенты
Как потратить деньги кампании, чтобы максимально повысить шансы победить на выборах?
ресурс — бюджет кампанииАвиакомпания
Какую минимальную цену назначить за билеты, чтобы уменьшить количество свободных мест — и не нарушить законы о перевозках?
ресурс — места в салонеИнтернет-провайдер
Как разместить дополнительные ресурсы, чтобы повысился уровень обслуживания клиентов?
ресурс — мощности сетиВсе эти задачи можно решить с помощью линейного программирования глава 29 Глава 29 · «Линейное программирование» Задача записывается так: максимизировать линейную функцию (прибыль) при наборе линейных неравенств (ресурсы, законы, мощности). Решает её симплекс-метод: допустимые решения образуют многогранник, оптимум всегда лежит в его вершине, и метод переходит из вершины в вершину, каждый раз улучшая результат. В главе разбирают, как свести к линейной программе кратчайшие пути и потоки в сетях, — то есть половина предыдущих задач оказывается её частным случаем. : цель и ограничения записываются линейными соотношениями, а дальше работает общий алгоритм. Разные отрасли — одна математика.
Задача о кратчайшем пути
Имеется карта дорог, на которой обозначены расстояния между каждой парой соседних перекрёстков. Наша цель — определить кратчайший путь от одного перекрёстка к другому. Количество возможных маршрутов может быть огромным, даже если исключить маршруты, пересекающие сами себя.
Алгоритм Дейкстры: растим множество вершин с уже известным расстоянием, каждый раз забирая из очереди с приоритетами ближайшую. Ответ здесь — A → v₂ → v₃ → v₅ → Б = 12.
Реальный мир → модель → граф
Карта дорог сама по себе уже модель. Чтобы задачу решал алгоритм, её моделируют ещё раз — в виде графа, и тогда становится применим весь арсенал книги.
Длиннейшая общая подпоследовательность
Подпоследовательность X — это сама последовательность X с некоторыми удалёнными элементами. Задача: для X и Y найти их длиннейшую общую подпоследовательность. Её длина — мера схожести: цепочки ДНК считают сходными, если у них есть длинная общая подпоследовательность.
элементы идут не подряд, но в том же порядке — это и есть подпоследовательность
подпоследовательностей: каждый элемент либо остаётся, либо удаляется
подпоследовательностей — ровно по той же причине
сопоставлений. При m = n = 20 это уже больше триллиона пар — а двадцать символов это очень короткая строка.
Выбирая все возможные подпоследовательности X и Y и сопоставляя их, задачу можно решить только за очень длительное время — если, конечно, m и n не оказываются очень малыми величинами.
c[i, j] — длина ЛОП префиксов X[1..i] и Y[1..j]; зелёным — совпадения, из которых собран ответ
Динамическое программирование
Большая задача разбивается на подзадачи поменьше: какова ЛОП префиксов X[1..i] и Y[1..j]. Каждая клетка таблицы — ответ на одну такую подзадачу, и считается он из уже заполненных соседей:
c[i, j] = c[i−1, j−1] + 1если xᵢ = yⱼ — символ идёт в ответc[i, j] = max(c[i−1, j], c[i, j−1])иначе — берём лучшее из двух соседейКаждая подзадача решается ровно один раз и записывается в таблицу, дальше её ответ берётся готовым. Вместо 2m·2n сопоставлений — m·n клеток: для строк по тысяче символов это миллион шагов. В правом нижнем углу — длина ответа, 4; пройдя по таблице обратно, собираем саму подпоследовательность A C B A.
Задачи, в которых решение складывается из решений перекрывающихся подзадач, решаются динамическим программированием. Подробнее о методе — в главе 15: там же рюкзак, перемножение цепочки матриц и оптимальные деревья поиска.
Топологическая сортировка
Имеется проект — библиотека составных частей, причём каждая часть может включать экземпляры других частей. Нужно перечислить все части так, чтобы каждая часть появлялась в списке до любой другой части, её использующей.
порядок сборки
это ровно то, что делает пакетный менеджер с деревом зависимостей
Если проект состоит из n частей, имеется n! возможных упорядочений. А факториал растёт быстрее даже показательной функции.
перебрать можно вручную
уже работа для компьютера
перебор закончится не при нас
больше, чем атомов в Солнечной системе
Нельзя просто сгенерировать все возможные упорядочения и для каждого проверить, соответствует ли расположение частей требованию — если, конечно, частей достаточно много.
Обход в глубину
Идём по графу в глубину и ставим каждой части два штампа: когда впервые вошли и когда закончили — то есть обошли всех, кто от неё зависит. В момент завершения кладём часть в начало списка.
Часть завершается позже всех своих зависимых — значит, в списке окажется раньше них. Это ровно то условие, которого требовала задача. Правильных порядков обычно несколько: здесь вышел ui-kit раньше icons, и это тоже верно.
Каждая часть и каждая связь просматриваются по одному разу — время Θ(V + E) вместо n! перебора. Если же в графе нашёлся цикл, порядка не существует вовсе, и обход сообщит об этом сам.
Задачи «упорядочить с учётом зависимостей» решаются топологической сортировкой графа.
Подробнее — в главе 22. Её же каждый день выполняют
turbo
Turborepo
Система сборки JS/TS-монорепозиториев от Vercel. Из package.json пакетов строит граф задач,
запускает их в топологическом порядке, независимые — параллельно, а результаты кеширует:
повторная сборка без изменений занимает секунды.
,
nx
Nx
Система сборки монорепозиториев от Nrwl. Строит граф проектов и по нему находит, какие пакеты
затронуло изменение (nx affected): тесты и сборка идут только для них и строго в порядке зависимостей.
и
bazel
Bazel
Система сборки Google — открытая версия внутреннего Blaze. Не привязана к языку: собирает Java, C++, Go и JS
из одного графа целей. Сборки герметичные и воспроизводимые, пересобирается только то, что зависит от изменений.
.
Выпуклая оболочка
Выпуклая оболочка точек — минимальный выпуклый многоугольник, содержащий эти точки. Наглядно: представьте точки гвоздями, торчащими из доски, и намотайте на них резинку так, чтобы все гвозди оказались внутри.
каждый гвоздь, вокруг которого обвивается резинка, становится вершиной оболочки
В качестве набора вершин оболочки может выступать любое из 2n подмножеств множества точек. И этого мало: недостаточно знать, какие точки являются вершинами, — нужен ещё порядок их обхода.
Каждая точка либо вершина оболочки, либо нет — как и с подпоследовательностями, ровно два варианта на точку.
Нужен порядок обхода
Тот же набор вершин можно соединить по-разному, и почти все способы дадут не выпуклый многоугольник, а самопересекающуюся фигуру. К перебору подмножеств добавляется перебор порядков.
Обход Грэхема
Точки сортируются по углу вокруг самой нижней, а дальше стек: каждая новая точка либо продолжает оболочку, либо выталкивает предыдущую, если та оказалась внутри. Время — O(n log n), и почти всё оно уходит на сортировку.
Метод Джарвиса — «заворачивание подарка»
Начинаем с заведомо крайней точки и каждый раз ищем следующую, вокруг которой «загибается бумага». Время — O(n·h), где h — число вершин оболочки: когда вершин мало, это выгоднее сортировки.
Оба метода разобраны в главе 33 «Вычислительная геометрия». Общее у них одно: внутренние точки отсеиваются по ходу дела, а не проверяются перебором подмножеств.
Что общего у этих задач?
Приведённые примеры не исчерпывают применение алгоритмов, но на них видны две общие характеристики, присущие многим интересным алгоритмам.
Множество вариантов-кандидатов
Кандидатов огромное количество, и подавляющее большинство решениями не являются. Кратчайший путь среди всех маршрутов, длиннейшая общая подпоследовательность среди 2m подпоследовательностей, порядок сборки среди n! перестановок, вершины оболочки среди 2n подмножеств — каждый раз поиск работающего, а лучше наилучшего, среди экспоненциального числа вариантов.
Практическое применение
Это не головоломки ради головоломок: за каждой задачей стоят деньги и время. Кратчайший маршрут снижает затраты труда и расходы горючего в перевозках, маршрутизатор быстрее доставляет сообщения, водитель между городами получает маршрут в навигаторе, а пакетный менеджер собирает проект в правильном порядке.
Исключение: не у всех задач есть «варианты»
Не все задачи сводятся к поиску среди кандидатов: у некоторых перебирать просто нечего,
и ответ получается прямым вычислением. Самый распространённый пример —
дискретное преобразование Фурье
Глава 30 · БПФ
Слева — как сигнал меняется во времени, справа — из каких частот он состоит. Это одни и те же данные
в двух представлениях, и переход между ними делает быстрое преобразование Фурье за O(n log n)
вместо O(n²) прямого счёта. Перебирать здесь нечего: множества кандидатов нет вовсе.
. На нём же держатся
умножение больших чисел
Через частотное представление
Число — это полином, а умножение полиномов через БПФ считается быстрее, чем столбиком.
Столбик — O(n²) операций с цифрами, через преобразование — O(n log n).
Ровно на этом стоит арифметика больших чисел в криптографии, где числа длиной в сотни цифр перемножают постоянно.
,
сжатие данных
Выбросить то, чего не заметят
Сигнал раскладывают на частоты, отбрасывают те, что вносят мало вклада, и собирают обратно.
Файл становится меньше, а на слух и на глаз разница почти не различима. Так устроены JPEG и MP3 —
родственным преобразованием, из той же семьи, что и БПФ.
и
обработка сигналов
Основа целой инженерной области
Фильтры, эквалайзеры, шумоподавление, распознавание речи — всё это работа с частотами, а значит,
преобразование Фурье внутри. В браузере это Web Audio API: визуализация звука и эквалайзер считаются
через FFT прямо на странице.
.
Структуры данных
Структура данных data structure — способ хранения и организации данных, облегчающий доступ к этим данным и их модификацию.
Массив
Доступ по индексу мгновенный. Вставка в середину — дорогая.
Связный список
Вставка и удаление дёшевы. Доступ по номеру — только перебором.
Дерево
Хранит порядок и быстро ищет. Требует поддержания балансировки.
Хеш-таблица
Поиск по ключу в среднем мгновенный. Порядка элементов нет.
Граф
Выражает связи между объектами. Обход дороже, чем у списка.
Ни одна структура данных не является универсальной и не может подходить для всех целей, поэтому важно знать преимущества и ограничения, присущие каждой из них.
Книга как «сборник рецептов»
Книгу можно рассматривать как сборник рецептов для алгоритмов. Правда, однажды вам встретится задача, для которой вы не сможете найти опубликованный алгоритм — и тогда рецепта не будет.
Конкретные задачи
Готовые разборы — те самые «рецепты»:
- Поиск медиан и порядковых статистик — глава 9
- Вычисление минимальных остовных деревьев — глава 23
- Определение максимального потока в сети — глава 26
Общие методы
То, что работает на задачах, которых в книге нет:
- «Разделяй и властвуй» — глава 4
- Динамическое программирование — глава 15
- Амортизационный анализ — глава 17
Главная мысль главы
Найти ответ умеет и перебор.
Алгоритм находит его верно на любом входе —
и не перебирая всё.
Сначала — постановка
Точно записать вход, выход и отношения между ними. Без постановки нечего ни решать, ни проверять: непонятно, что считать правильным ответом.
Корректность — на всех экземплярах
Тесты показывают, что ошибки нет на трёх входах. Доказательство — что её нет ни на одном. Алгоритм, который «иногда ошибается», — это осознанный выбор, а не находка в проде.
Перебор — не решение
Когда кандидатов 2n или n!, нужен метод: динамическое программирование, обход графа, геометрия. А если оптимум недостижим — приближение с доказанной границей.
Вся остальная книга — это набор таких методов и доказательства того, почему они работают.
Как разрабатывать свои алгоритмы
Книга учит методам разработки алгоритмов и их анализа. Это позволяет разрабатывать корректные алгоритмы и оценивать их эффективность самостоятельно.
Точно описать вход и выход. Пока это не сделано, решать нечего.
«Разделяй и властвуй», динамическое программирование, жадный выбор — на что похожа задача?
Показать, что ответ верен на любом допустимом входе, а не на трёх примерах.
Посчитать, как растёт время работы с ростом входа — до того, как это увидит прод.
Это и есть ответ на вопрос «зачем читать книгу, если алгоритмы уже написаны»: написаны не все, а четыре шага выше работают для любой задачи.
Сложные задачи
Обычная мера эффективности алгоритма — скорость: время, в течение которого алгоритм выдаёт результат. Но существуют задачи, для которых неизвестны эффективные методы решения.
Эффективные алгоритмы
Сортировка, кратчайшие пути, потоки, оболочки — всё это решается быстро, и книга показывает как.
Чем меряем
Скоростью: как растёт время работы при росте объёма входных данных. Это главная характеристика.
А есть другие
Задачи, для которых никто не знает эффективного алгоритма. Они называются NP-полными.
«Неизвестен эффективный алгоритм» — это не то же самое, что «задача нерешаема». Решить её можно, просто время решения растёт так быстро, что при больших входах это теряет практический смысл.
NP-полные задачи
Простыми словами: это задачи, для которых быстро проверить готовый ответ можно, а быстро найти его никто не умеет — и все они связаны между собой.
Проверить — легко
Дали готовый маршрут — посчитать его длину и сравнить с лимитом можно мгновенно.
Найти — тяжело
Лучшие известные способы в худшем случае сводятся к перебору огромного дерева вариантов.
Они связаны друг с другом
Это не список разных бед, а одна беда в разных обличьях — и в этом главная интрига.
Не доказано, что эффективного алгоритма не существует. Доказано лишь, что его пока никто не нашёл. Это разные утверждения — и именно поэтому вопрос до сих пор открыт.
Почему NP-полные задачи интересны
Книга называет три причины — и все три стоит понять.
Вопрос открыт
Эффективный алгоритм их решения до сих пор не найден. Но и не доказано, что такого алгоритма не существует.
Никто не знает, существует ли эффективный алгоритм для NP-полных задач.
главная открытая проблема информатикиЗамечательное свойство набора
Если эффективный алгоритм существует хотя бы для одной из этих задач, то его можно сформулировать и для всех остальных.
Взаимосвязь между NP-полными задачами и отсутствие методов их эффективного решения вызывают ещё больший интерес к ним.
одна дверь открывает всеГраница проходит рядом
Некоторые NP-полные задачи похожи, но не идентичны задачам, для которых эффективные алгоритмы известны.
Учёных волнует, как небольшое изменение формулировки может значительно ухудшить эффективность самого лучшего из известных алгоритмов.
шаг в сторону — и задача другаяЗачем это знать разработчику
Потому что в реальных приложениях NP-полные задачи возникают неожиданно часто — и от того, узнаете вы такую задачу или нет, зависит, куда уйдут ваши недели.
Ищу идеальный алгоритм
Если перед вами встанет задача найти эффективный алгоритм для NP-полной задачи, скорее всего, вы потратите много времени на безрезультатные поиски.
- Недели на оптимизацию того, что не оптимизируется
- Ощущение, что вы просто недостаточно умны
- Результата всё равно нет
Ищу достаточно хорошее
Если же вы покажете, что задача принадлежит к разряду NP-полных, то вместо самого лучшего из всех возможных решений можно попробовать найти достаточно эффективное.
- Понятная цель и понятный срок
- Решение, которое работает уже завтра
- Честный разговор с бизнесом об ожиданиях
Знание о NP-полноте — это не про теорию. Это смена стратегии: от «найти идеальное любой ценой» к «найти достаточно хорошее и поехать дальше».
Задача о коммивояжёре
Компания грузового автотранспорта, один центральный склад. Каждый день грузовик загружается и развозит груз по нескольким точкам, а в конце дня должен вернуться на склад. Чтобы сократить расходы, нужно выбрать такой порядок доставки, при котором пройденное расстояние минимально.
Эта задача хорошо известна как «задача о коммивояжёре», и она является NP-полной. Эффективный алгоритм решения для неё неизвестен.
Приближённые алгоритмы
Эффективный алгоритм для задачи о коммивояжёре неизвестен, однако при некоторых предположениях можно указать такие алгоритмы, в результате выполнения которых полученное расстояние будет ненамного превышать минимально возможное.
Точный оптимум
Гарантированно лучший ответ — и время работы, которое растёт так, что при реальных размерах задачи ответа вы не дождётесь.
- Идеально, но не вовремя
- При 20 точках перебор уже невозможен
- Бизнесу нужен маршрут сегодня, а не идеальный маршрут когда-нибудь
Приближённый алгоритм
Ответ не идеален, но отличается от оптимального не более чем на известную величину — и получается быстро.
- Отклонение ограничено и доказано, а не «на глаз»
- Работает на реальных размерах данных
- Подобные алгоритмы рассматриваются в главе 35 Глава 35 · «Приближённые алгоритмы» Ключевое понятие — коэффициент аппроксимации: доказанная граница, во сколько раз ответ может отличаться от оптимального. Для задачи о коммивояжёре с неравенством треугольника есть алгоритм с коэффициентом 2 — маршрут гарантированно не длиннее удвоенного оптимального, — и алгоритм Кристофидеса с коэффициентом 1.5. Там же разбирают вершинное покрытие, покрытие множества и рюкзак. Главное отличие от эвристики: здесь граница доказана, а не измерена на тестах.
Маршрут на 3% длиннее оптимального, посчитанный за секунду, полезнее идеального маршрута, который считался бы до конца недели.
Почему процессоры перестали ускоряться
Многие годы можно было считать скорость работы процессоров устойчиво возрастающей. Однако физика накладывает фундаментальные ограничения.
Больше вычислений за единицу времени — просто за счёт того, что процессор быстрее тикает.
С ростом частоты выделение тепловой мощности растёт более чем линейно — микросхемы могут просто начать плавиться.
Проектировщики всё активнее используют другой путь — процессоры, содержащие несколько «ядер».
Это поворот, который касается всех, кто пишет код: бесплатного ускорения больше нет. Программа, которая умеет занять только одно ядро, с новым процессором быстрее не станет.
Многоядерный процессор
Многоядерные компьютеры можно уподобить нескольким компьютерам на одном обычном процессоре; другими словами, это разновидность «параллельных компьютеров».
Один процессор
Вся надежда — на тактовую частоту одного вычислительного блока.
Несколько ядер
Несколько вычислительных единиц внутри одного процессора — каждая со своей работой.
Чтобы добиться более высокой производительности от многоядерных компьютеров, мы должны разрабатывать алгоритмы с учётом возможности параллельных вычислений. Само по себе наличие ядер ничего не ускоряет.
Многопоточные алгоритмы
В главе 27 представлена модель для «многопоточных» алгоритмов, которая использует преимущества многоядерности.
Модель многопоточных алгоритмов обладает рядом преимуществ с теоретической точки зрения и образует основу для ряда успешных программ, включая программу для игры в шахматы.
Упражнения
Пять упражнений из раздела 1.1. Сначала думаем сами — решение открывается кнопкой. Карточки кликабельны: каждая ведёт на своё задание.
Ответы на упражнения — не единственно правильные. Это примеры рассуждения, с которыми можно спорить: как раз то, ради чего мы собираемся на встречах клуба.
Приведите реальные примеры задач, в которых возникает потребность в сортировке или вычислении выпуклой оболочки.
Пример решения
Сортировка
- Товары по цене в каталоге. Пользователь хочет увидеть сначала дешёвое — это ровно задача сортировки, и от неё зависит, останется ли он на странице.
- Пользователи в админке. По дате регистрации, по активности, по фамилии — упорядочивание делает список пригодным для работы.
- Результаты поиска по релевантности. Найти мало, нужно ещё расположить в правильном порядке: смотрят в основном первые позиции.
- Файлы в проводнике. По имени, размеру, дате изменения — сортировка здесь промежуточный шаг к тому, чтобы найти нужный файл глазами.
Выпуклая оболочка
- Географические точки. Очертить минимальную область, в которой работает служба доставки или в которой зафиксированы события.
- Обработка изображений. Найти границу объекта, выделенного на снимке, — оболочка даёт его внешний контур.
- Робототехника. Робот обходит препятствие, зная его выпуклую оболочку: это дешёвое приближение формы, достаточное для планирования пути.
- Геометрические задачи и игры. Проверка столкновений: пересечение выпуклых оболочек считается гораздо быстрее, чем пересечение сложных форм.
Общее во всех примерах: задача реального мира сначала переводится в постановку с точным входом и выходом — и только после этого становится решаемой алгоритмом.
Какими ещё параметрами, кроме скорости, можно характеризовать алгоритм на практике?
Пример решения
Прямо следует из главы
- Потребление памяти. Алгоритм может быть быстрым, но требовать копии всех данных — на большом входе это решающий фактор.
- Корректность. Глава вводит её как отдельное свойство: даёт ли алгоритм верный результат на любом допустимом входе.
- Требования к хранилищу. Данные в основной памяти, на диске или на ленте — от этого зависит, какой алгоритм вообще применим.
- Возможность параллельного выполнения. Раздел о многоядерности прямо говорит: алгоритм нужно разрабатывать с учётом параллельности.
- Чувствительность к входным данным. Количество элементов, их исходный порядок, ограничения на значения — всё это меняет поведение алгоритма.
Практические характеристики сверх текста
- Масштабируемость. Хорошо ли алгоритм ведёт себя, когда данных становится в сто раз больше.
- Сложность реализации и сопровождения. Алгоритм, который в команде понимает один человек, — риск, а не преимущество.
- Устойчивость к худшему случаю. Средняя скорость может быть отличной, а худший случай — обваливать сервис.
- Стабильность и предсказуемость. Сохраняет ли сортировка порядок равных элементов; одинаково ли ведёт себя от запуска к запуску.
- Стоимость. Процессорное время в облаке — это счёт в конце месяца.
Левая колонка опирается на текст главы, правая — на инженерную практику. Разделять их полезно: на собеседовании и в споре важно понимать, откуда взят аргумент.
Выберите одну из встречавшихся вам ранее структур данных и опишите её преимущества и ограничения.
Пример решения — хеш-таблица
Преимущества
- Быстрый поиск по ключу в среднем. Время доступа почти не зависит от количества элементов — это её главное свойство.
- Удобное отображение ключ → значение. Естественная модель для кешей, индексов, словарей, подсчёта количеств.
- Вставка и удаление тоже дёшевы — в среднем такие же, как и поиск.
Ограничения
- Нет естественного порядка элементов. «Дай все ключи по возрастанию» или «дай диапазон» — не её задача, нужна другая структура.
- Возможны коллизии. Разные ключи попадают в одну ячейку, и их приходится разрешать — это цена скорости.
- Производительность зависит от реализации и распределения ключей. Плохая хеш-функция или недружелюбные данные — и «в среднем быстро» превращается в «медленно».
- Платит памятью. Таблице нужен запас свободных ячеек, иначе коллизий становится слишком много.
Это пример ответа, а не единственно правильный вариант: точно так же можно было разобрать массив, связный список или дерево. Суть упражнения — увидеть, что у любой структуры есть и то и другое, ровно как и говорит глава: универсальной структуры данных не существует.
Что общего между задачей об определении кратчайшего пути и задачей о коммивояжёре? Чем они различаются?
Пример решения
Общее
- Обе формулируются на графе: вершины, рёбра, веса рёбер
- Обе про маршрут и про минимизацию суммарного расстояния
- У обеих огромное множество вариантов-кандидатов
- Обе имеют прямое практическое применение в перевозках и сетях
Кратчайший путь
- Найти лучший путь между двумя вершинами
- Промежуточные вершины проходить необязательно
- Возвращаться в начало не нужно
- Есть эффективный алгоритм — глава 24
Коммивояжёр
- Найти оптимальный маршрут через все заданные точки
- Каждую точку нужно посетить
- Обязательно вернуться в исходную точку
- NP-полная: эффективный алгоритм неизвестен — глава 34
Главное различие — вычислительная сложность. Формулировки соседние: «доехать из А в Б» и «объехать всё и вернуться». Но первая решается эффективно, а для второй эффективного алгоритма никто не знает — и приходится довольствоваться приближёнными решениями (глава 35). Это ровно та третья причина интереса к NP-полным задачам: небольшое изменение формулировки резко меняет сложность.
Сформулируйте задачу, в которой необходимо только наилучшее решение. Сформулируйте также задачу, в которой может быть приемлемым решение, достаточно близкое к наилучшему.
Пример решения
Нужно только оптимальное решение
- Минимальная стоимость операции, когда даже небольшое отклонение недопустимо: расчёт сдачи, начисление процентов, сверка баланса. «Почти правильная» сумма — это просто неправильная сумма.
- Проверка подписи или пароля. Ответ бинарный: совпало или нет. Приближённого варианта здесь не существует в принципе.
- Сортировка. Частично отсортированный список — не решение задачи сортировки, а другой результат.
Достаточно близкого к наилучшему
- Маршрут доставки на день. Он не обязан быть абсолютно минимальным — достаточно, чтобы отличался от оптимального не более чем на приемлемую величину. Курьеру нужен маршрут в шесть утра, а не идеальный маршрут к вечеру.
- Раскладка блоков или расписание задач. Почти оптимальное распределение по ядрам или по сменам работает не хуже, а считается несравнимо быстрее.
- Рекомендации и выдача. Идеального порядка не существует вовсе — важно, чтобы сверху было релевантное.
Вторая колонка — это и есть область приближённых алгоритмов (глава 35): когда точный оптимум слишком дорог, ищут решение с доказанной границей отклонения. Признак, по которому задача попадает во вторую колонку: цена отклонения измерима и невелика, а цена ожидания — велика.
Что далее
Антон Помазков
Артём Никифоров